标注、清洗、转换、划分,一条链走完
九个模块对应 YOLO 数据集从原始素材到 data.yaml 的每一步,全部在本机完成。
数据集质量检测
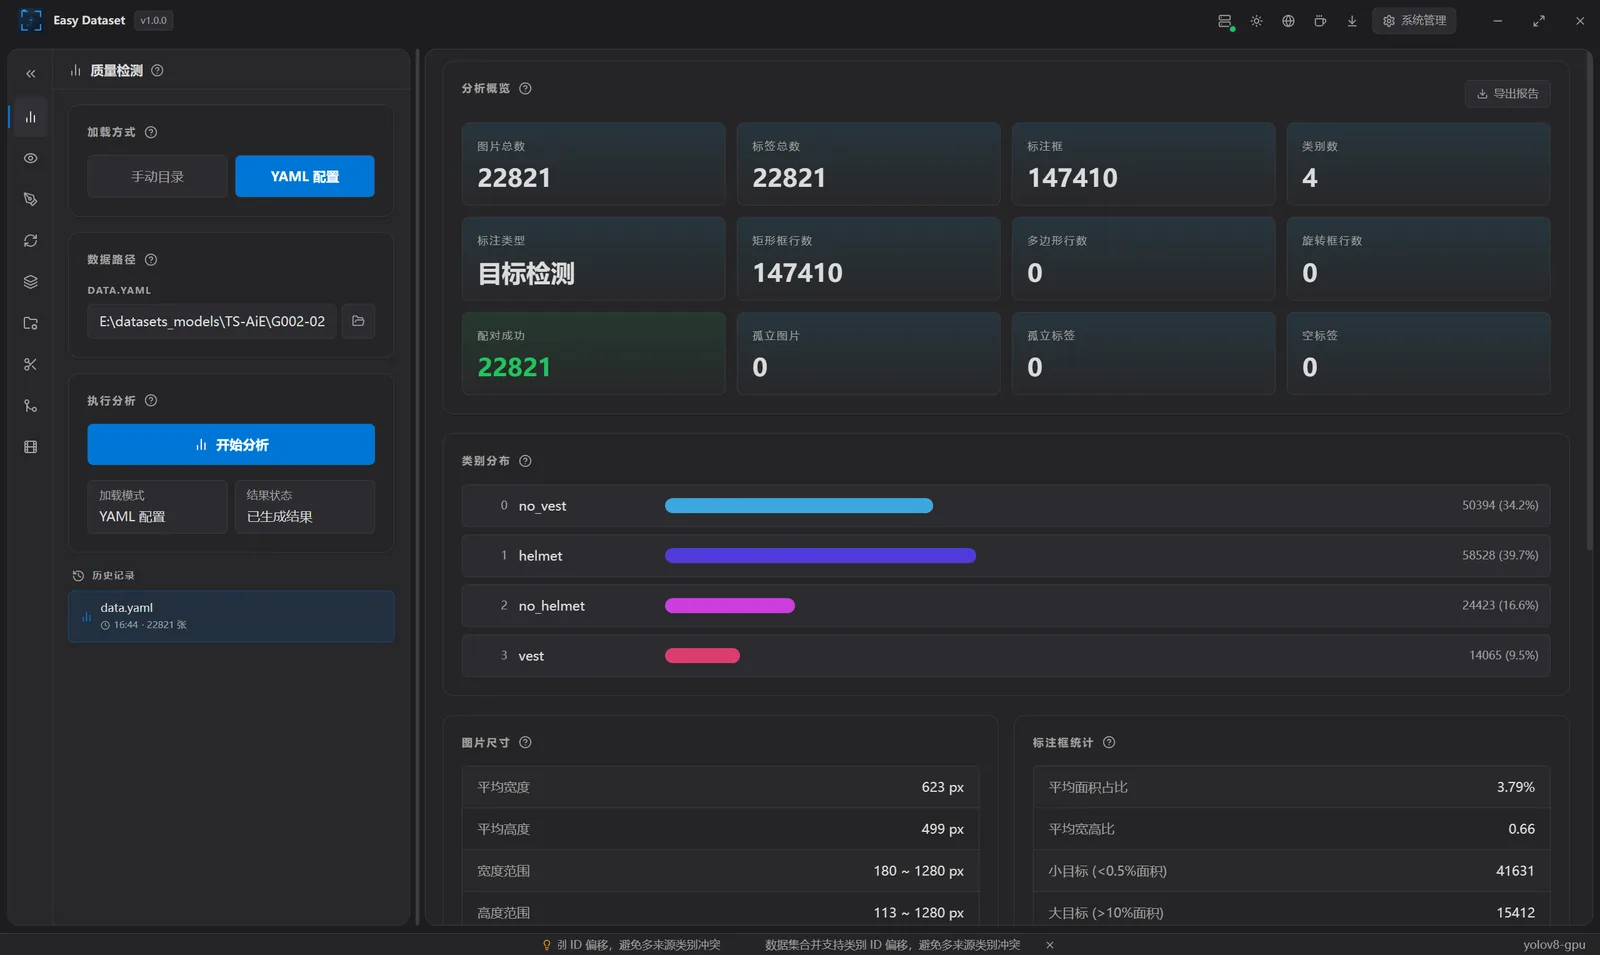
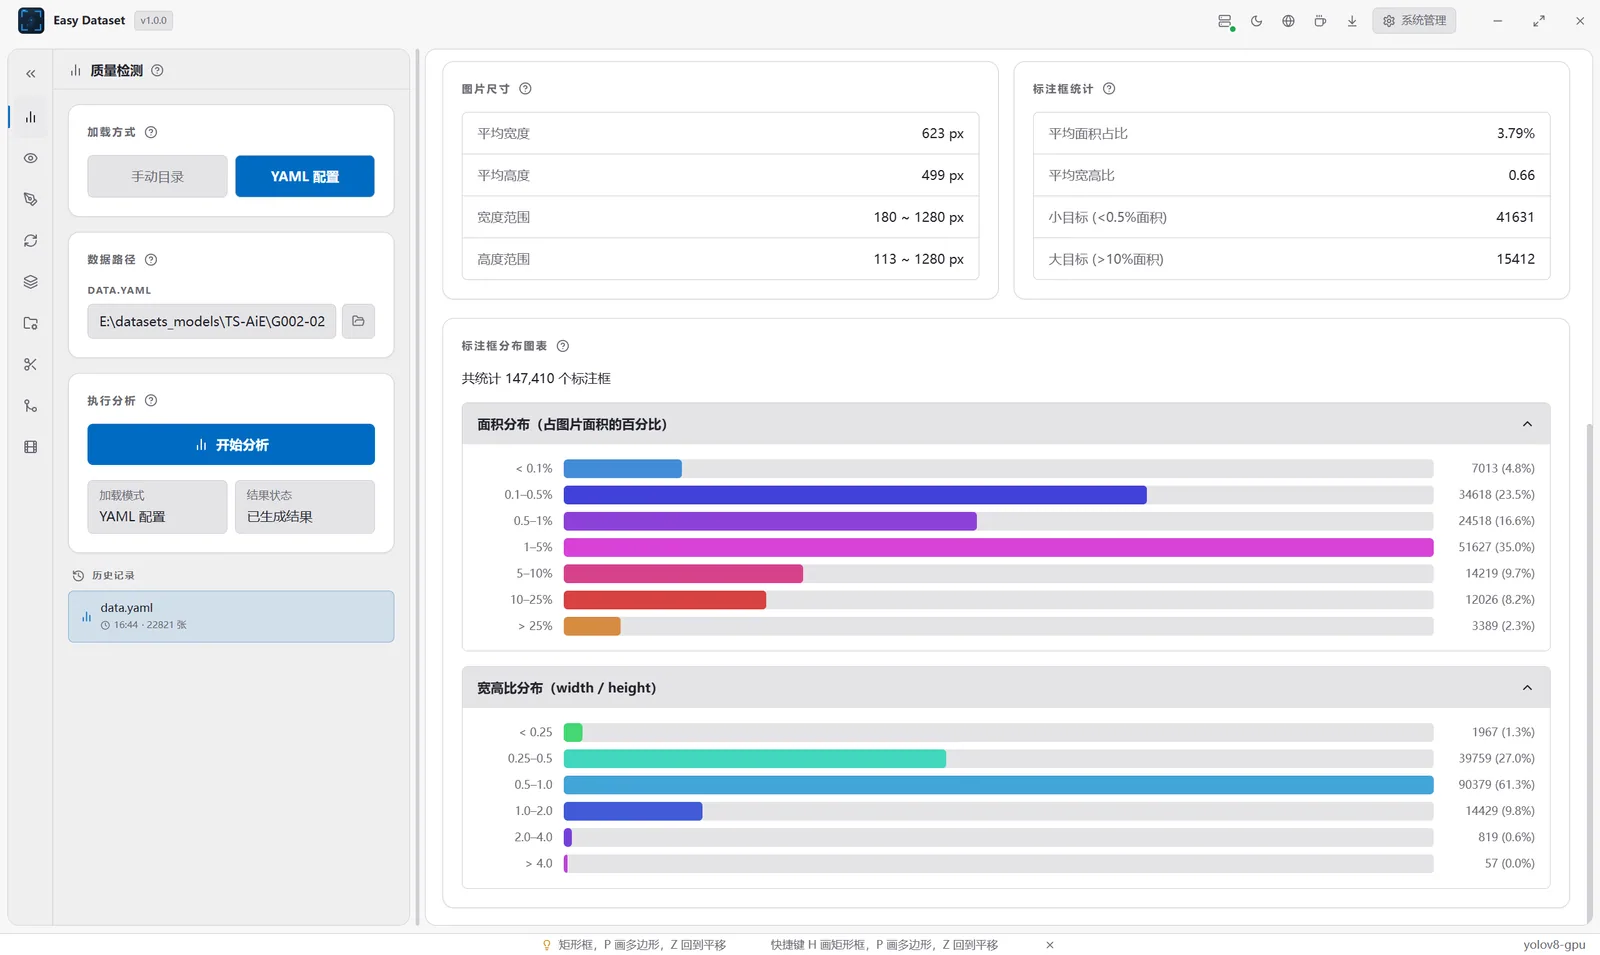
统计图片、标签、标注框与类别数量,列出孤立图片、孤立标签与空标签,给出类别分布、框面积与宽高比直方图;还会判出这份数据到底是检测、旋转框还是分割,混用时标为「混合」。
- 矩形 / 多边形 / 旋转框行数分开统计
- 一键导出 Markdown 报告,分析结果留历史可回看
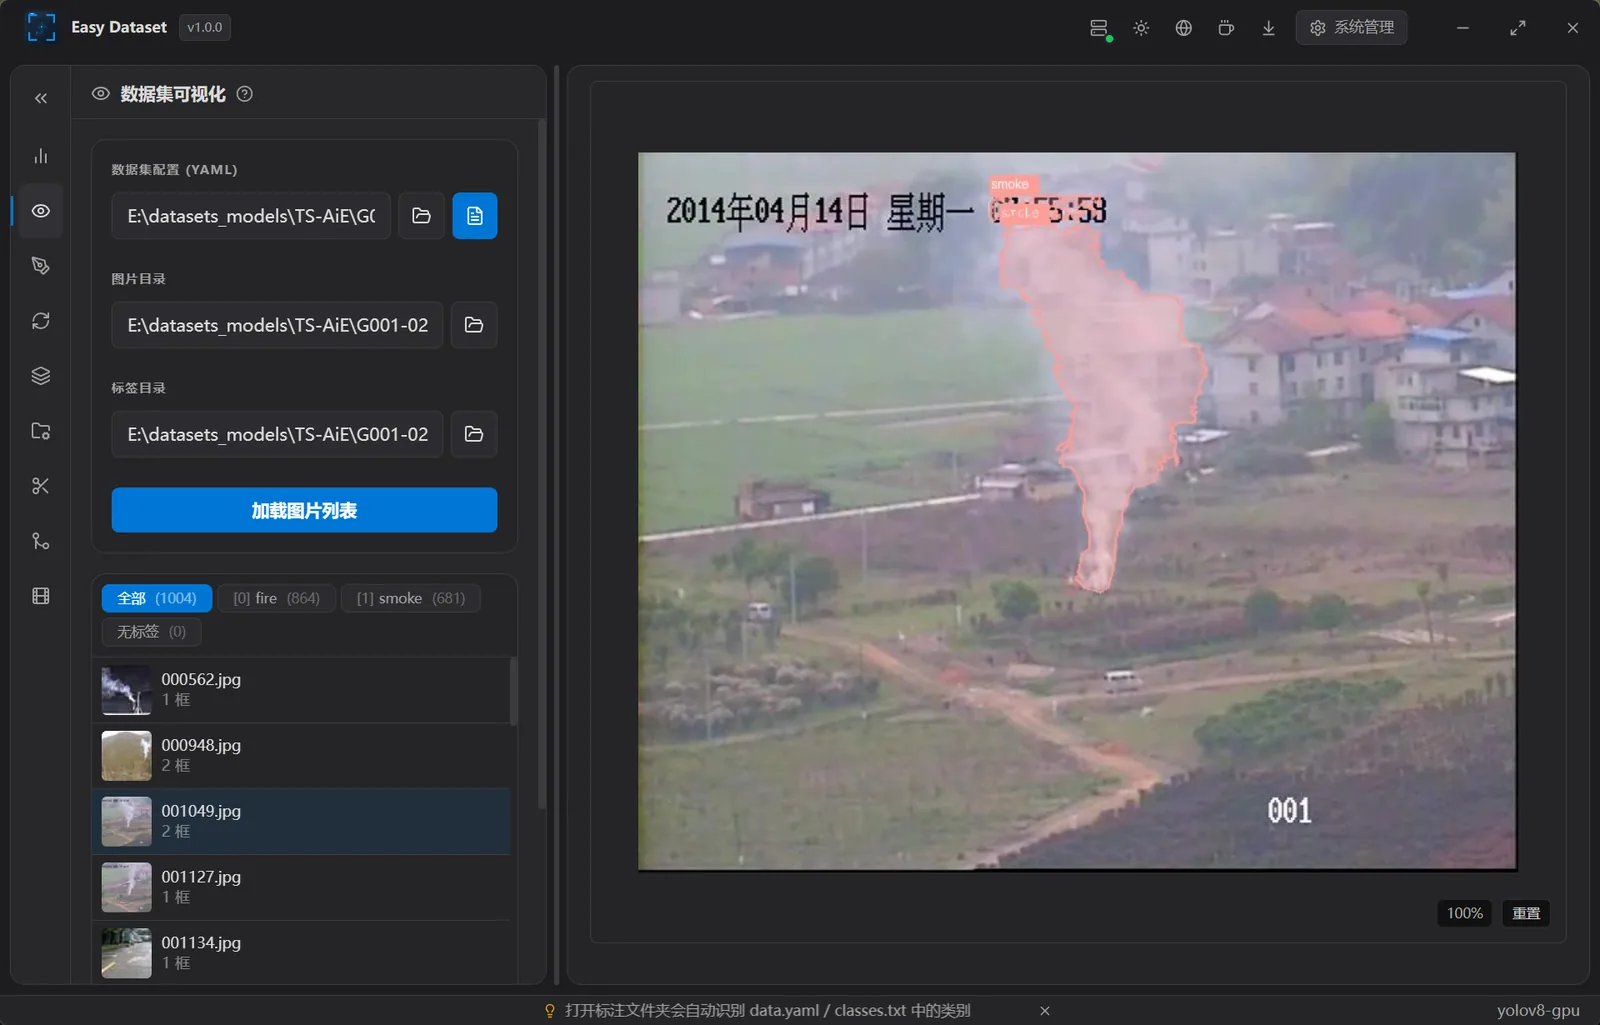
带框可视化浏览
缩略图墙按「全部 / 已标注 / 未标注」或指定类别过滤,点开即看原图与标注:检测画矩形、分割画半透明多边形、旋转框画四点轮廓,三种类型一眼分得开。
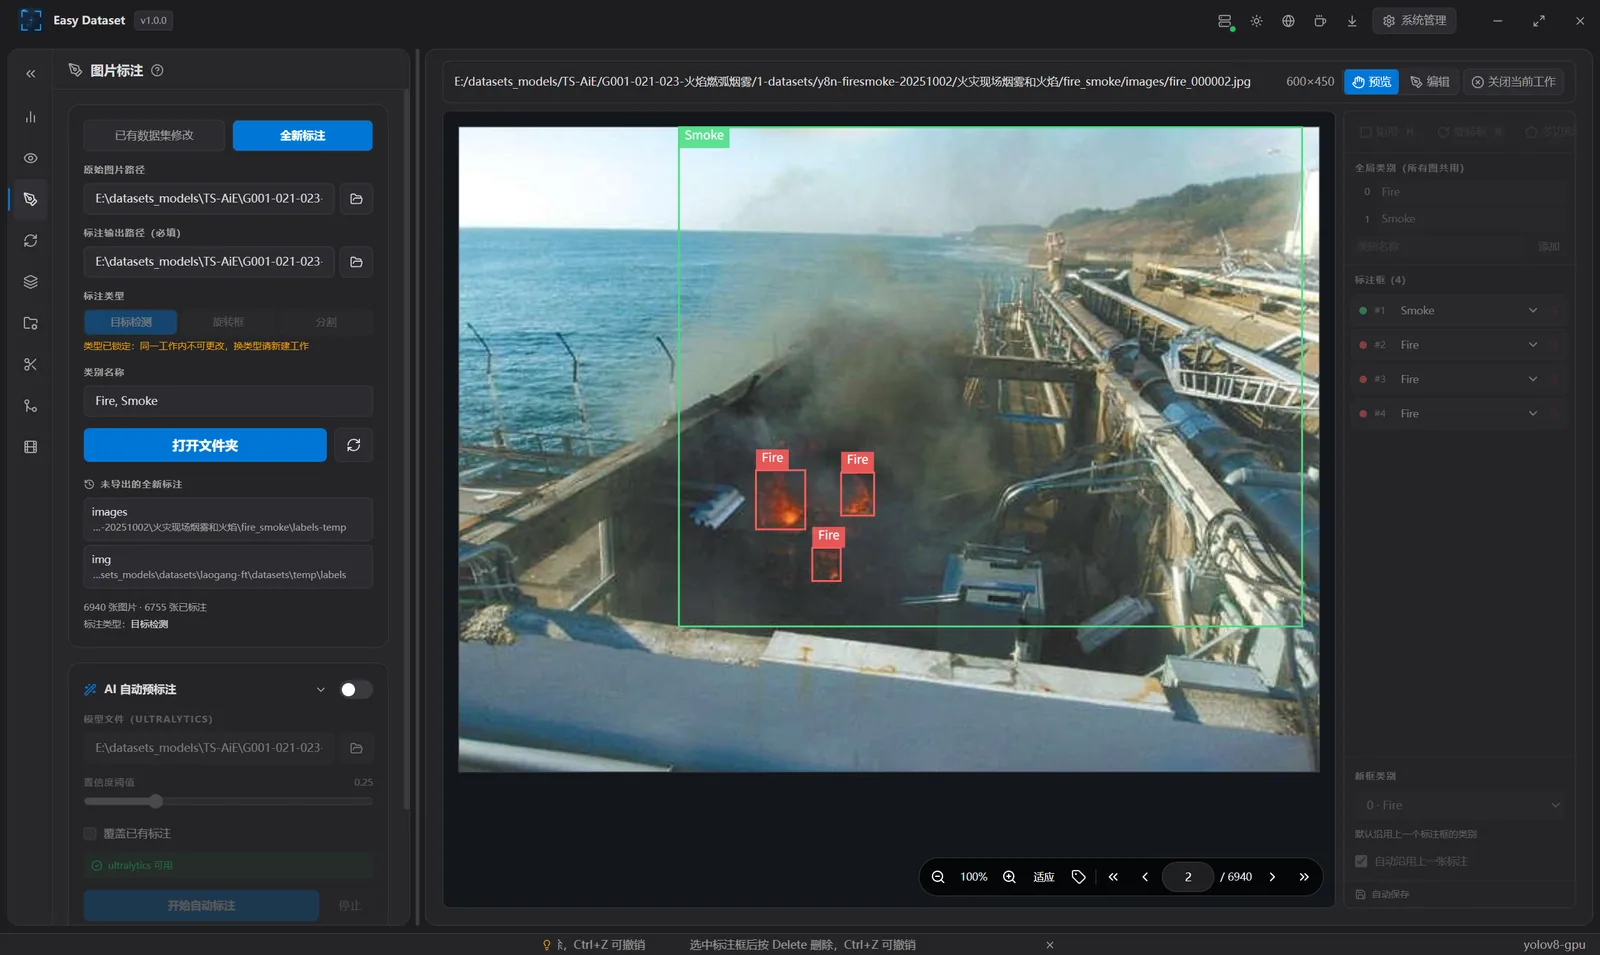
图片标注
矩形、旋转框、多边形三种画法:拖框、拖手柄转角度、逐点描边。支持撤销重做、跨图复制粘贴、滚轮缩放与全套快捷键,编辑自动保存,类别名写回 classes.txt。
- 可改已有数据集,也可从纯图片目录新建标注
- Ctrl+V 跨图粘贴、自动沿用上一张的标注,连续帧很省事
AI 自动预标注
用自己训练好的模型先跑一遍,再人工修低置信度区域。ultralytics 能加载的权重都能用:YOLOv5~v12、RT-DETR,检测 / 分割 / 旋转框模型均可,.pt / .onnx / .engine 都认。
- 可设置信度阈值,只补空白图或覆盖已有标注
- 进度实时显示,可随时停止
格式互转与导出
LabelMe JSON、Pascal VOC XML 转 YOLO TXT,YOLO 转 VOC XML,以及导出 COCO JSON(分割写真实多边形与 area);类别名到 ID 的映射与「类别重映射」都在界面上填。
- 导出标注时可选「原始 / 检测 / 分割」三种模式
- 结果写到指定目录,原标注文件保持不动
标签编辑
批量替换类别 ID、删除某个类别的全部标注、多个 ID 一次性重排序、重命名类别;可原地修改,也可输出到新目录,执行后给出受影响文件数。
文件一致性管理
一致性检查列出孤立图片与孤立标签;可删空标签、为未标注图片补空标签、按前缀加序号批量重命名、修复打不开的 JPEG。全部支持先预览再执行。
数据集划分
按 train / val / test 比例随机划分(三者之和须为 1.00),随机种子固定即可复现,并自动生成可直接训练的 data.yaml。
数据集合并
多来源合成一份,支持类别 ID 偏移与逐项映射,可选给文件名加来源编号前缀,避免不同来源的同名图片互相覆盖。
视频抽帧
普通抽帧按帧间隔取图,可设格式、JPEG 质量与文件名前缀;AI 智能抽帧只保留含目标类别的帧,并同时写出 YOLO 标签,抽完就能直接进标注页修正。
- 超长视频可按时长分段并行(需 ffmpeg)
- 加载视频信息后先看 FPS、时长与预计抽取数量
五个最常遇到的场景
从接手别人标好的数据,到把工具本身也交接清楚。
别人标好的数据集,先体检再动手
选 data.yaml 或直接填图片与标签目录,很快就能看到图片数、标签数、标注框数、类别数与配对情况。
两张卡片直接告诉你这份数据是目标检测、旋转框还是分割,甚至把矩形框、多边形、旋转框的行数分开数——写「混合」就是训练前得先统一。
孤立图片、孤立标签、0 字节的空标签各自单列;下方接类别分布与标注框面积 / 宽高比直方图,小目标占比偏高一眼看得出。
三种标注类型,同一块画布上画完
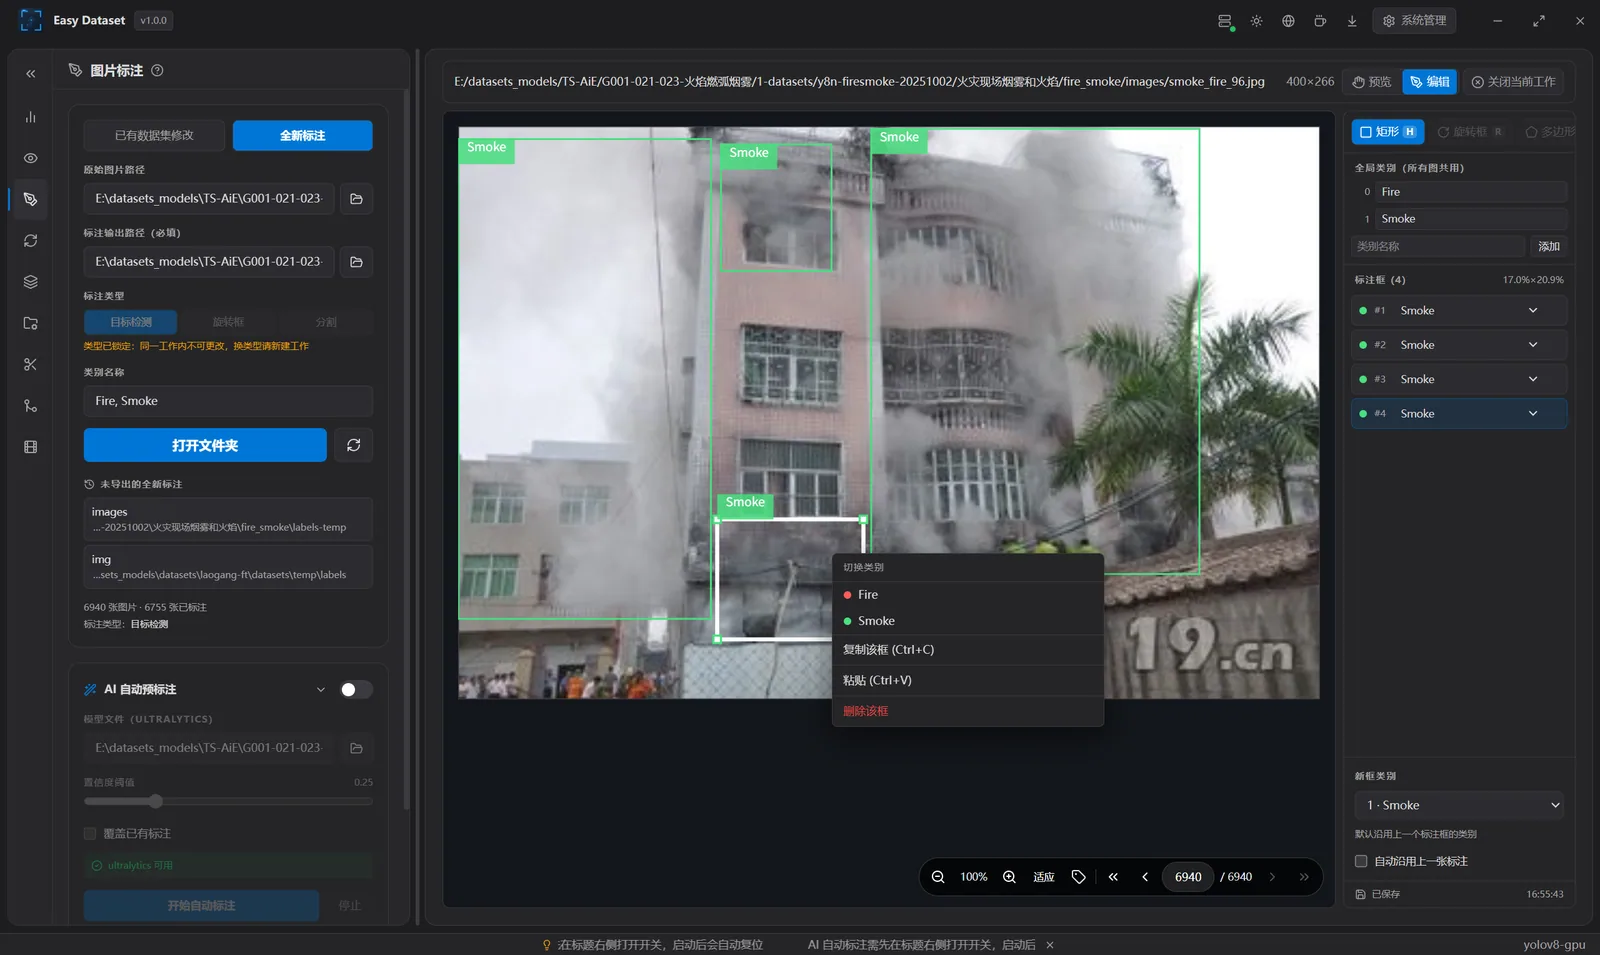
矩形、旋转框、多边形对应 H / R / P 三个键:拖两个角画框,拖手柄改角度,逐点描出轮廓。中键平移、滚轮缩放、A / D 翻页。
右侧类别面板管全局类别、当前框类别与每个框的归属;右键可直接切换类别、复制粘贴或删除。
可以改已有数据集(留空输出路径就原地写回),也可以只给一个图片文件夹从零开始标;编辑后自动保存,类别名写回 classes.txt。
模型先跑一遍,人只改不对的地方
左侧「AI 自动预标注」选自己训练好的权重,设置信度阈值,一整个文件夹先标完;ultralytics 能加载的检测 / 分割 / OBB 权重都行。
已有标注默认不覆盖(只补空白的图),需要重标时再勾「覆盖已有标注」。
跑完逐张过一遍,改完的框自动落盘;进度实时显示,中途可停。
带框预览,先看清再决定改什么
缩略图卡片带框数,顶部按「全部 / 已标注 / 未标注」或具体类别过滤,接手别人的数据集时不用装额外的标注软件。
预览里检测画矩形、分割画半透明多边形并描轮廓、旋转框只画四点轮廓,三种标注类型在视觉上就分得清。
大目录分页加载缩略图,不会为了看一眼先把内存吃满。
版本、依赖、环境,一个弹窗管完
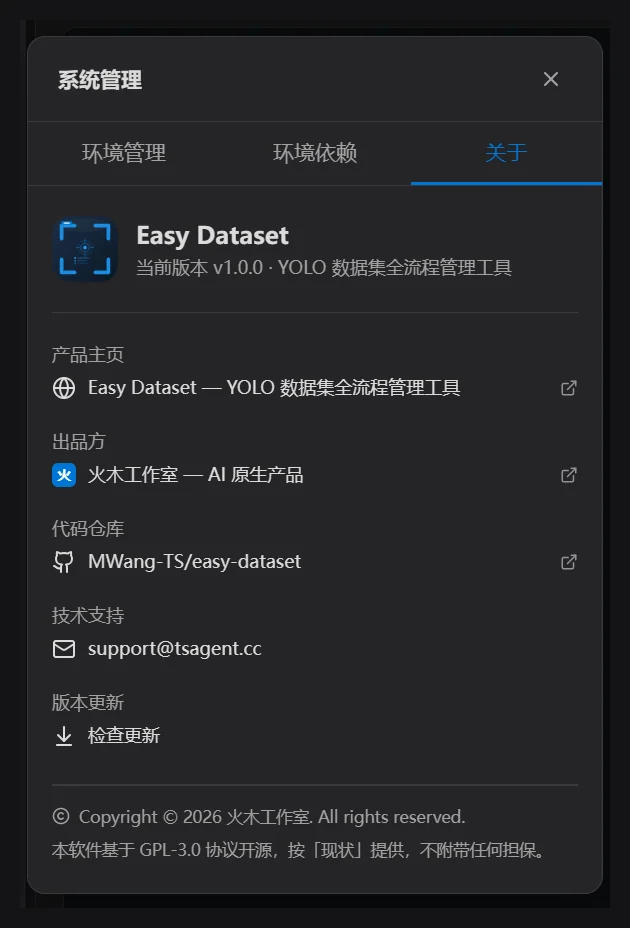
「关于」里直接看到版本号、产品主页、代码仓库与技术支持入口,检查更新只读公开的发布清单;协议与免责声明也写在同一处。
「环境依赖」逐条列出 Python、ffmpeg 与每个包的安装状态,勾上「包含 AI 依赖」就能导出 environment.yml,新机器用 Easy Conda 导入即可重建。
「环境管理」列出扫描到的 conda 环境并标记依赖是否齐全,换环境后后端自动用新解释器重启——不会出现界面和实际运行的代码不是一套的情况。
设计上的取舍
确定的部分交给代码,不确定的部分交给你决定。
数据不离开本机
后端只监听 127.0.0.1,不对外暴露;需要时可在运行目录放 .env 设 API_TOKEN。工业数据、医疗影像、安防视频无需上传云端。
轻量桌面应用
Tauri 2 外壳 + React 前端 + 本地 Flask 服务,安装包只有几兆。升级后自带后端会按版本号同步到独立目录,旧进程不会捣乱。
环境依赖可导出
系统管理里直接列出必需依赖与 AI 依赖的安装状态,一键导出 environment.yml,在 Easy Conda 里导入就能在新机器建好同一套环境。
多语言与明暗主题
界面提供简体中文、English、日本語,明暗主题在标题栏切换,语言与主题都会记忆。
使用前你可能想先知道
使用前需要准备什么环境?
首次运行会引导选择本机已有的 conda 环境,也可以手动指定 python 路径。基础功能需要 Flask、OpenCV、Pillow、PyYAML 等依赖,向导会标注环境是否齐全;AI 预标注与智能抽帧额外需要 ultralytics,分段并行还需要 ffmpeg。
会把数据集上传到云端吗?
不会。质量检测、标注、转换、划分、合并与抽帧都在本机完成,后端只监听 127.0.0.1,不依赖任何在线服务。
能标注旋转框和分割吗?
能。矩形、旋转框(OBB)、多边形分割三种画法都支持,打开已有数据集时按标签内容自动判定类型。4 点多边形不会被误判成旋转框(需满足对边等长、邻边垂直),OBB 数据集也不会被降级导出为矩形。
AI 预标注支持哪些模型?
ultralytics 能加载的权重都可以:YOLOv5~v12、RT-DETR,检测 / 分割 / 旋转框模型都行,格式支持 .pt / .onnx / .engine / .torchscript / .tflite 与 OpenVINO 目录。分类模型不做框标注;阈值与是否覆盖已有标注都可调。
支持哪些标注格式?
读:YOLO TXT(检测 / OBB / 分割)、LabelMe JSON、Pascal VOC XML;写:YOLO TXT、VOC XML、COCO JSON。转换前建议先备份,尤其「原地修改」类操作。
数据集很大时会卡吗?
文件按需逐个读取,缩略图分页加载,不会把整份数据集一次性读进内存;但预览与导出会生成副本,磁盘建议预留数据集体积 2 倍以上空间。
是开源的吗?
是,使用 GPL-3.0 许可证,源码与安装包都在 GitHub 上,完整使用说明书在仓库 wiki 目录。
把事做完的写法
Easy Dataset 的实操文章,边看边做。
现在就开始使用
免费下载,本地运行。数据留在你自己的机器上。
这是桌面应用,请在电脑上打开本页面下载。
其它格式
SHA256 校验值
下载即表示同意按「现状」使用,软件不收集使用数据。